分流直提与 OCR / 并行 Worker / SQLite 增量缓存 / 3 万文件实战脚本
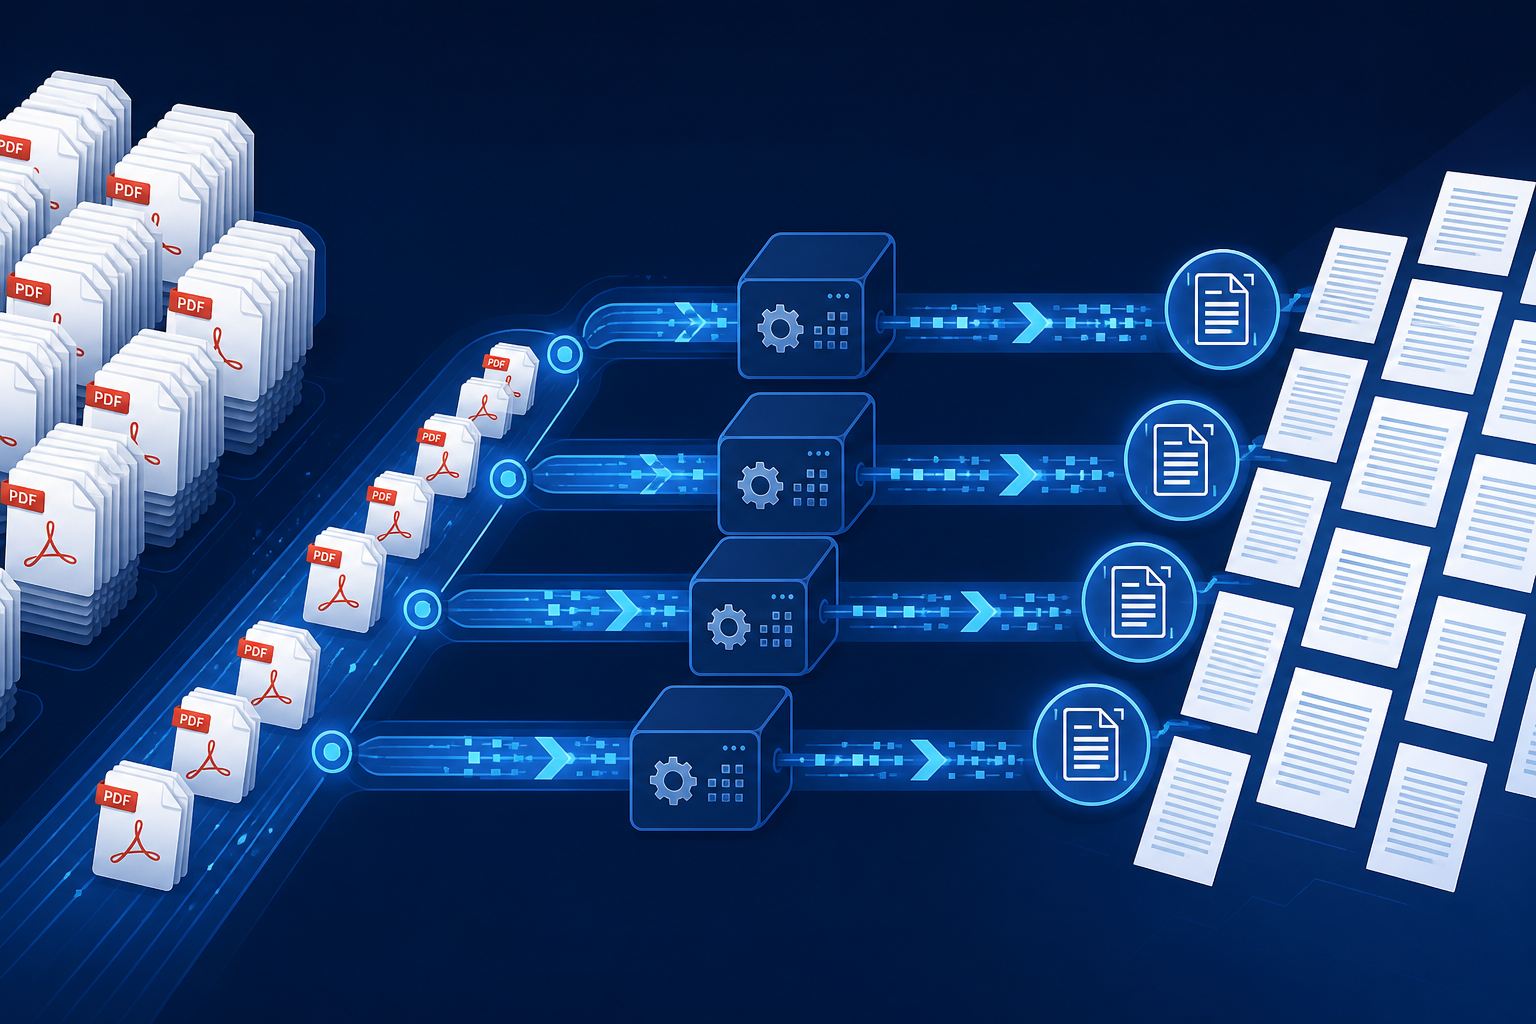
档案室迁移、合同审计、发票归档——当你面对几万份 PDF时,第一反应往往是「装个 OCR 软件点批量」。这在几百份时尚且可行,到了万级规模,瓶颈立刻从识别精度变成磁盘 I/O、重复劳动和无法断点续跑。本文给出一套在 2026 年仍经得起压测的流水线:先判断 PDF 是否自带文本层,再决定是否 OCR,用多进程并行 + 增量缓存,把 3 万份文档在一夜之间跑完。
核心结论先说:最快的方法不是「最强的 OCR」,而是尽量不让 OCR 上场。带文本层的 PDF 用 PyMuPDF 直提,速度是 OCR 的 50–200 倍;只有扫描件才进 Tesseract / PaddleOCR 队列。旧方案「全部 OCR 一遍」适合任何批量场景 应改为 按类型分流。
为什么几万份 PDF 不能「一把梭」OCR?
一份 20 页的扫描件 OCR 大约需要 30–90 秒(取决于 DPI 和语言包)。3 万份全走 OCR,即使 8 核并行也要数天到数周。而同样 3 万份里,往往有 40%–70% 是 Word / Excel 导出的「真 PDF」,文本层完整,page.get_text() 毫秒级就能抽出全文。
先做分类,再谈识别
分类依据
判断逻辑
- 文本层检测——任意一页
get_text()非空且字符数 > 50,标记为text_native - 扫描件特征——无文本层、页面为全图,标记为
needs_ocr - 加密 / 损坏——打开失败写入
error队列,不阻塞主流程
设计原则:把「识别」拆成「分类 → 提取 → 兜底 OCR」三阶段,每阶段可独立扩缩容与断点续跑。
三条路线:直提、OCR、混合分流
| 路线 | 适用 | 速度(单文件) | 精度 |
|---|---|---|---|
| PyMuPDF 直提 | 有文本层的 PDF | 0.01–0.5 s | 100%(原文) |
| pdftotext / pdfplumber | 简单版式、表格少 | 0.1–2 s | 高 |
| Tesseract / PaddleOCR | 扫描件、照片 PDF | 30–120 s | 85–98% |
- 直提(Extract)
- 读取 PDF 内嵌字体编码的文本流,不经过图像识别,是万级批量的默认首选。
- OCR(Optical Character Recognition)
- 把每页渲染成位图再识别字符,CPU/GPU 密集,仅对
needs_ocr队列启用。 - 混合分流(Hybrid)
- 生产环境推荐:Walker 遍历 → Classifier 打标 → Extract Worker 与 OCR Worker 分池并行。
最快架构:元数据先行 + 并行 Worker
推荐架构如下(单机 8 核可扛 3 万文件;更多核线性扩展):
- Walker——
os.scandir递归收集路径,写入任务表,不打开 PDF - Classifier——多进程快速打开首页,写
file_type字段 - Extract Pool——处理
text_native,输出 JSONL / SQLite - OCR Pool——仅消费
needs_ocr,可用 Cmd + 任务管理器监控 Mac 负载
工具对比:该用谁?
| 工具 | 语言 | 万级批量 | 备注 |
|---|---|---|---|
| PyMuPDF (fitz) | Python | ⭐⭐⭐⭐⭐ | 速度最快,API 完整 |
| pdfplumber | Python | ⭐⭐⭐⭐ | 表格抽取强 |
| pdftotext | CLI | ⭐⭐⭐⭐ | Shell 管道友好 |
| Tesseract | CLI/C | ⭐⭐⭐ | 多语言成熟 |
| PaddleOCR | Python | ⭐⭐⭐⭐ | 中文场景更准 |
| Adobe API | REST | ⭐⭐ | 按量计费,不适合万级 |
实战脚本:3 万文件 overnight 跑完
以下脚本演示分类 + 直提 + SQLite 增量缓存(OCR 队列可另起进程消费 needs_ocr 行):
#!/usr/bin/env python3
import sqlite3, fitz
from pathlib import Path
from multiprocessing import Pool, cpu_count

DB = "pdf_index.sqlite3"
ROOT = Path("/data/invoices")

def init_db():
    con = sqlite3.connect(DB)
    con.execute("""CREATE TABLE IF NOT EXISTS docs (
        path TEXT PRIMARY KEY, md5 TEXT, kind TEXT,
        text TEXT, status TEXT DEFAULT 'pending')""")
    con.commit(); return con

def classify(path: str) -> tuple:
    try:
        doc = fitz.open(path)
        sample = "".join(doc[i].get_text() for i in range(min(3, len(doc))))
        kind = "text_native" if len(sample.strip()) > 50 else "needs_ocr"
        doc.close()
        return (path, kind, "classified")
    except Exception as e:
        return (path, "error", str(e))

def extract(path: str) -> tuple:
    doc = fitz.open(path)
    text = "\n".join(page.get_text() for page in doc)
    doc.close()
    return (path, text, "done")

if __name__ == "__main__":
    files = [str(p) for p in ROOT.rglob("*.pdf")]
    with Pool(cpu_count()) as pool:
        for path, kind, st in pool.imap_unordered(classify, files, chunksize=64):
            # 写入 DB;needs_ocr 留给 OCR worker
            pass
在 Apple Silicon Mac 上,chunksize=64 通常比默认的 1 更能吃满 I/O;SSD 上 3 万个小文件分类可在 20–40 分钟 内完成。直提阶段再花 1–2 小时;剩余扫描件按 OCR 池容量排队即可。
性能调优:别在 I/O 上自杀
- 增量 MD5 缓存——文件未变则跳过,重跑只处理新增与修改项
- 避免 NFS 上跑 OCR——先把批次同步到本地 NVMe,再处理
- 限制渲染 DPI——OCR 用 200–300 DPI 足够,600 DPI 只会慢 4 倍
- 按语言分包——中文用
chi_sim,英文用eng,混用会降低准确率
深入了解:为什么 PyMuPDF 比 pdfplumber 快?
PyMuPDF 底层是 MuPDF C 库,打开文档和抽取文本几乎零 Python 开销;pdfplumber 基于 pdfminer.six,版式分析更细但慢 3–10 倍。若你只需要全文检索而非精确表格坐标,PyMuPDF 是万级批量的默认答案。
常见问题
批处理上线前,这四个问题被问得最多:
- 能识别 PDF 里的印章吗?——直提拿不到印章文字;需 OCR + 图像检测,或专用模型
- 加密 PDF 怎么办?——有密码的先解密再入队;无权限的记入
skipped - 需要 GPU 吗?——直提不需要;PaddleOCR 在 GPU 上约快 3–5 倍
- 怎么对接全文检索?——JSONL 导入 Elasticsearch,或 SQLite FTS5 足够中小规模
回到标题:几万份 PDF 最快的识别扫描方式,是混合分流 + 并行 + 增量缓存,而不是单一 OCR 工具。先把带文本层的文件用 PyMuPDF 秒级抽完,再把算力留给真正的扫描件——这才是万级规模下能一夜跑完的关键。
把批量 OCR 丢到可快照的云 Mac 节点
M4 独享节点,按天租用,SSH 开箱即用
新加坡 · 日本 · 韩国 · 香港 · 美国节点可选
几万份 PDF 的批处理会占满 CPU 和磁盘 I/O,用独立云 Mac 跑流水线,主力机不用通宵挂着。 查看 ZekVPS 云端 Mac mini 套餐 — 快照回滚 + 并行 Worker,大批量文档处理更安心。